
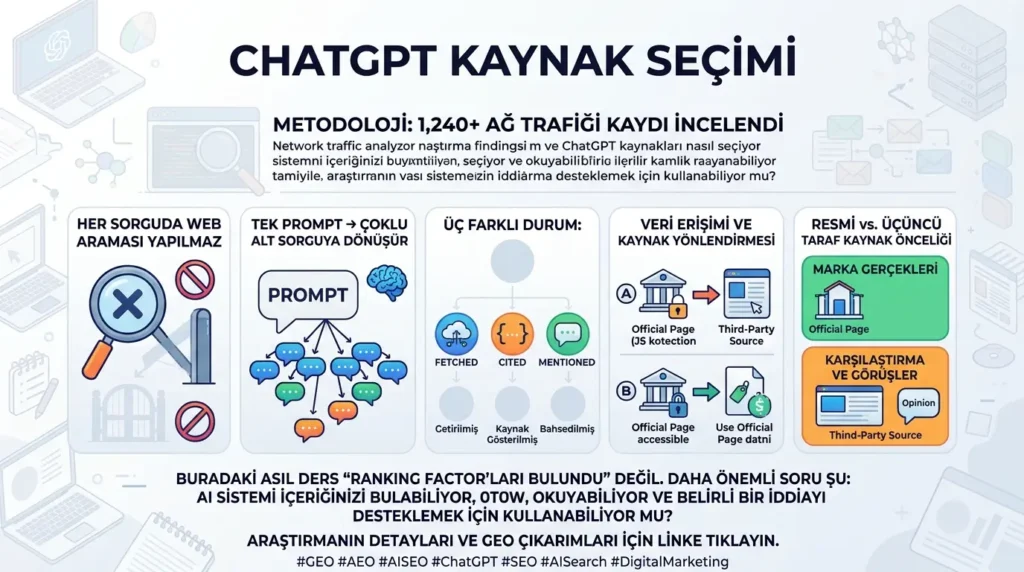
Kısa Özet: ChatGPT’nin kaynak seçimini yalnızca verdiği cevaplara bakarak analiz etmek yeterli olmayabilir. Yaklaşık 1.240 kaynak kaydını ağ trafiği üzerinden inceleyen bir çalışma; ChatGPT’nin bazı sorgularda web’e hiç çıkmadığını, bazı sorguları çok sayıda alt aramaya böldüğünü ve bir sayfanın getirilmesi, citation olarak kullanılması ve markanın cevapta anılması arasında önemli farklar bulunduğunu gösteriyor. Bulgular özellikle crawl edilebilir içerik, üçüncü taraf kaynaklar ve açık HTML yapısının GEO açısından neden önemli olabileceğine dair yeni ipuçları sunuyor.
ChatGPT, Google AI Overviews ve diğer üretken yapay zeka sistemlerinde görünür olmak isteyen markaların en temel sorularından biri:
“AI sistemleri hangi kaynakları seçiyor?”
Bugüne kadar yapılan birçok AI visibility araştırması, binlerce prompt çalıştırıp sonuçlarda hangi marka ve domainlerin göründüğünü ölçüyor. Bu yöntem geniş örneklem sunuyor ancak sistemin arka planda kaynakları nasıl topladığını doğrudan göstermiyor.
Suganthan Mohanadasan tarafından gerçekleştirilen ve Search Engine Journal’da yayımlanan çalışma ise farklı bir yöntem kullanıyor. Araştırmacı, ChatGPT’nin verdiği son cevaptan ziyade tarayıcıdaki ağ trafiğinde bulunan verileri inceleyerek sistemin hangi kaynakları getirdiğini, hangi sorguları oluşturduğunu ve bunları nasıl sınıflandırdığını analiz ediyor.
Ancak araştırmanın önemli bir sınırlaması var:
Çalışma tek bir Pro hesabında, birkaç günlük kullanım sırasında ve ağırlıklı olarak SaaS ile teknoloji sorgularında elde edilen yaklaşık 1.240 kaynak kaydına dayanıyor.
Bu nedenle yüzdesel sonuçları evrensel ChatGPT davranışı olarak değerlendirmek doğru değil.
ChatGPT Her Sorguda Web’de Arama Yapıyor mu?
Hayır.
Araştırmanın en önemli bulgularından biri, bazı kullanıcı sorgularının hiçbir web araması başlatmadan cevaplanabilmesi. Çalışmada ağ trafiğinde turn_use_case olarak adlandırılan bir alan gözlemleniyor. Araştırmacı testleri sırasında sorguların:
- instant search,
- shopping,
- text,
- local,
- thinking,
- image generation
gibi farklı kullanım türlerine ayrıldığını bildiriyor.
Özellikle text kategorisine giren sorguların web araması yapmadan modelin mevcut bilgisi üzerinden cevaplandığı gözlemlenmiş. Bu ayrım GEO açısından önemli. Çünkü bir sorguda ChatGPT web’e hiç çıkmıyorsa o anda yayımladığınız yeni bir sayfanın citation olarak seçilme ihtimali de doğal olarak bulunmuyor.
OpenAI’nin resmi açıklamaları da ChatGPT’nin gerektiğinde web search kullanabildiğini, ancak web aramasının cevap üretmenin tek yöntemi olmadığını belirtiyor.
Detaylı Bilgi: “ChatGPT web search” → OpenAI Yardım Merkezi
GEO Açısından Bunun Anlamı Ne?
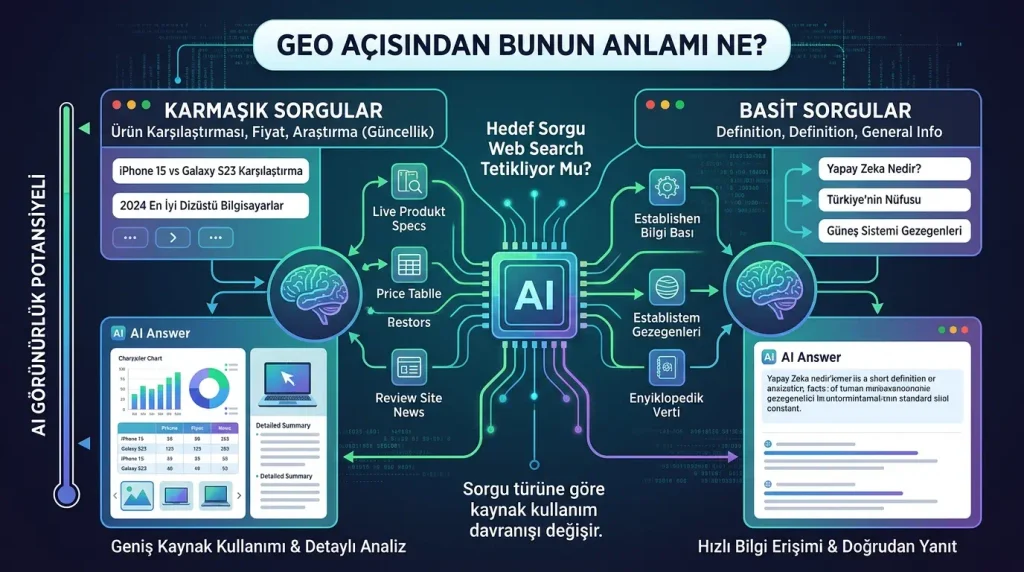
Her keyword’ün aynı AI visibility potansiyeline sahip olduğunu varsaymamak gerekiyor. Bir GEO çalışmasına başlamadan önce şu soru önem kazanıyor:
Hedef sorgu gerçekten web search tetikliyor mu?
Özellikle güncellik, ürün karşılaştırması, fiyat veya araştırma gerektiren sorgular ile basit tanım ve genel bilgi sorgularının kaynak kullanım davranışı birbirinden farklı olabilir.
Bu Makale İlginizi Çekebilir: GEO Hazırlık Rehberi
ChatGPT Tek Bir Sorguyla mı Arama Yapıyor?
Her zaman değil.
Araştırmada özellikle daha kapsamlı karşılaştırma veya araştırma gerektiren sorgularda kullanıcının yazdığı tek promptun çok sayıda alt sorguya dönüştürülebildiği görülüyor.
Örneğin ürün veya yazılım karşılaştırması isteyen tek bir sorgu:
- ürün adı + fiyat,
- marka + pricing,
- resmi fiyat sayfası,
- alternatif ürünler,
- belirli özellikler,
- üçüncü taraf incelemeleri
gibi çok sayıda ayrı aramaya dönüşebiliyor.
OpenAI’nin resmi ChatGPT Search dokümantasyonu da bu temel mekanizmayı doğruluyor.
OpenAI’ye göre ChatGPT, daha ilgili sonuçlar bulabilmek için kullanıcının sorusunu bir veya birden fazla hedefli arama sorgusuna yeniden yazabiliyor ve ilk sonuçlardan sonra daha spesifik sorgular da çalıştırabiliyor.
Makalaede Referans Verilen Araştırma: “bir veya birden fazla hedefli sorgu” → OpenAI
Fan-Out Query GEO İçin Neden Önemli?
Bu yapı klasik keyword optimizasyonundan farklı bir problem yaratıyor.
Kullanıcı: “En iyi kurumsal SEO araçlarını karşılaştır.”
diye sorabilir. Ancak ChatGPT arka planda:
“X pricing”
“X vs Y”
“X features”
“site.com pricing”
gibi farklı sorgular çalıştırabilir.
Dolayısıyla GEO çalışmalarında yalnızca kullanıcının başlangıç promptunu hedeflemek yerine, o promptun oluşturabileceği fan-out query ekosistemini de düşünmek gerekiyor.
ChatGPT’nin result_source Alanı Ne Gösteriyor?
Araştırmanın teknik açıdan en dikkat çekici kısmı result_source adlı alan.
İncelenen kaynak kayıtlarında dört farklı değer gözlemlenmiş:
serplabradorbrightoxylabs
Araştırmacı bright ve oxylabs etiketlerinin Bright Data ve Oxylabs altyapılarıyla ilişkili göründüğünü belirtiyor.
labrador ise Reuters, Financial Times, Wall Street Journal, Wikipedia ve bazı büyük yayınların bulunduğu farklı bir kaynak grubu olarak gözlemlenmiş.
Ancak burada dikkatli olmak gerekiyor.
Bu etiketlerin varlığı ağ trafiğinde gözlemlenebilir bir bulgu olsa da bunların OpenAI içindeki ticari veya ranking anlamları resmi olarak açıklanmış değil.
Örneğin “labrador kesin olarak lisanslı yayıncı havuzudur” şeklinde bir sonuç çıkarmak, araştırmacının gözleminden daha ileri bir iddia olur.
Fetched, Cited ve Mentioned Arasındaki Fark Nedir?
Çalışmanın SEO ve GEO açısından belki de en önemli sonucu bu ayrım.
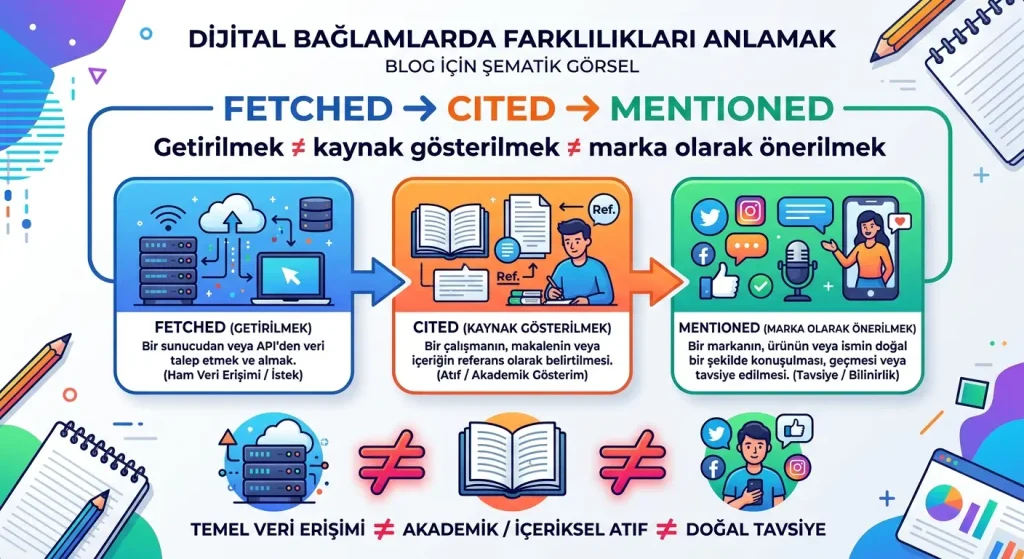
Bir kaynak için üç farklı sonuç ortaya çıkabilir.
Fetched
ChatGPT sayfayı bulup içeriğini kendi bağlamına getirir. Ancak kullanıcı bu kaynağın getirildiğini görmeyebilir.
Cited
Kaynak, cevap içerisindeki belirli bir iddiayı destekleyen tıklanabilir citation haline gelir.
Mentioned
Markanın veya şirketin adı cevapta yer alır ancak marka bu iddianın kaynağı olmayabilir.
Bu üç sonuç aynı şey değildir. Bir site ChatGPT tarafından çok sık fetch edilebilir ancak nadiren citation alabilir.
Benzer biçimde bir marka cevapta önerilebilir ancak öneriyi destekleyen citation üçüncü taraf bir inceleme sitesine ait olabilir.
ChatGPT Neden Resmi Site Yerine Üçüncü Taraf Kaynak Kullanabilir?
Araştırmadaki ilginç örneklerden biri fiyat ve ürün özellikleriyle ilgili.
ChatGPT bazı ürünlerin resmi fiyat sayfalarını bulmasına rağmen fiyat bilgisinin JavaScript arkasında yüklenmesi nedeniyle içeriği doğrudan okuyamadığında üçüncü taraf kaynaklara yönelmiş. Bu gözlem önemli bir GEO prensibine işaret ediyor:
Önemli bilgiler makine tarafından kolay okunabilir olmalı.
Özellikle:
- fiyat,
- ürün özelliği,
- paket içeriği,
- teknik spesifikasyon,
- tarih,
- istatistik,
- karşılaştırma verisi
gibi bilgiler yalnızca görsel içerisinde veya karmaşık JavaScript bileşenlerinin arkasında tutulmamalı.
Plain HTML GEO İçin Neden Önemli?
Bir AI sistemi fiyat sayfasına ulaşıp fiyat bilgisini çıkaramıyorsa aynı bilgiyi:
- G2,
- Reddit,
- inceleme sitesi,
- haber kaynağı,
- karşılaştırma platformu
gibi başka bir kaynaktan alabilir.
Bu durumda markanın kendi verisi kullanılırken citation başka bir siteye gidebilir.
GEO açısından hedef yalnızca crawl edilebilir olmak değil, kritik bilgi birimlerini açık ve kolay çıkarılabilir biçimde sunmak olmalı.
Üçüncü Taraf Kaynaklar Neden Önemli?
Araştırma, resmi marka sayfalarının özellikle fiyat, özellik ve ürün verilerinde önemli kaynaklar olabildiğini gösteriyor. Ancak “hangi ürün daha iyi?” gibi değerlendirme gerektiren sorularda üçüncü taraf içerikler daha fazla önem kazanıyor.
Bu mantıklı bir ayrım. Bir marka kendi ürününün:
“Fiyatı 99 dolar.”
bilgisinin en güçlü kaynağı olabilir.
Ancak: “Bu kategorideki en iyi ürün hangisi?”
sorusunda markanın kendi sayfası bağımsız değerlendirme kaynağı olarak aynı ağırlığa sahip olmayabilir.
Bu nedenle AI Search görünürlüğü yalnızca owned media üzerinden kurulamaz.
Markaların:
- sektörel yayınlarda,
- güvenilir karşılaştırmalarda,
- inceleme sitelerinde,
- forumlarda,
- kullanıcı tartışmalarında
nasıl temsil edildiği de önem kazanıyor.
Reddit ve YouTube Bulguları Nasıl Yorumlanmalı?
Araştırmacının küçük örnekleminde Reddit ve YouTube sık fetch edilen kaynaklar arasında bulunuyor. Ancak citation davranışları önemli ölçüde farklılaşıyor.
Reddit birçok kez citation alırken YouTube çalışmadaki belirli örneklemde hiç citation almamış.
Araştırmacı bunun olası mekanik nedenlerinden birinin, Reddit sayfalarında metnin doğrudan okunabilir olması; YouTube arama sonuçlarında ise çoğu durumda videonun kendisinden çok metadata’ya erişilmesi olabileceğini düşünüyor.
Ancak bu oranları genellememek gerekiyor. Çalışmanın kendisi de bunun ağırlıklı olarak SaaS ve teknoloji sorgularından oluşan küçük bir örneklem olduğunu özellikle vurguluyor.
ChatGPT İçin GEO Çalışmalarında Neler Yapılmalı?
Bu araştırmadan çıkarılabilecek en uygulanabilir sonuçları birkaç başlıkta toplamak mümkün.
Kritik Bilgileri Açık HTML İçerisinde Sunun
Fiyat, özellik, istatistik ve ürün bilgilerinin JavaScript veya görsel arkasında kalmamasına dikkat edin.
Fan-Out Query’leri Düşünün
Yalnızca ana promptu değil, ChatGPT’nin o prompttan türetebileceği alt sorguları da karşılayan içerik yapıları oluşturun.
Tek Güçlü Sayfayı Tercih Edin
Aynı iddia için onlarca zayıf sayfa üretmek yerine o konunun en güçlü kaynağı olabilecek kapsamlı bir sayfa hazırlamak daha anlamlı olabilir.
Üçüncü Taraf Görünürlüğünü Artırın
Özellikle karşılaştırma ve öneri sorgularında bağımsız kaynaklarda yer almak önemli.
Citation ile Brand Mention’ı Ayrı Ölçün
Markanın cevap içerisinde geçmesi ile web sitesinin citation almasını aynı KPI olarak değerlendirmeyin.
Önce Sorgunun Web Search Kullanıp Kullanmadığını Kontrol Edin
Her prompt citation üretme fırsatı oluşturmayabilir.
Bu Araştırmanın Kısıtları Neler?
Çalışmanın en önemli avantajı, yalnızca cevapları değil sistemin tarayıcıya gönderdiği bazı yapısal verileri incelemesi. Ancak aynı zamanda önemli sınırlılıkları bulunuyor.
Araştırma:
- tek bir hesapta,
- birkaç gün boyunca,
- birkaç düzine sorguyla,
- ağırlıklı olarak SaaS ve teknoloji konularında
gerçekleştirildi. Bu nedenle “Reddit şu oranda citation alıyor” veya belirli bir source pipeline’ın en çok kullanıldığı gibi sonuçlar genel ChatGPT davranışı olarak değerlendirilmemeli.
Ayrıca sistem hızla değişiyor. Bugün gözlemlenen dahili alanlar ve sorgu davranışları gelecekte farklılaşabilir. Bu nedenle araştırmanın en değerli kısmı oranlar değil, ortaya koyduğu mekanik ayrımlar.
Kısacası ChatGPT Görünürlüğü Sadece “İyi İçerik Yazmak” Değildir
Çalışma ChatGPT için kesin bir ranking algoritması ortaya çıkarmıyor. Zaten araştırmacı da sunucu tarafındaki gerçek ranking skorlarının veya trust formüllerinin ağ trafiğinden görülemediğini açıkça belirtiyor.
Ancak araştırma GEO açısından daha temel bir gerçeği gösteriyor. Bir içeriğin ChatGPT’de görünür olabilmesi için birbirinden farklı aşamalardan geçmesi gerekiyor:
Sorgunun web search tetiklemesi
↓
Sayfanın bulunması
↓
İçeriğin makine tarafından okunabilmesi
↓
İlgili bilgi parçasının çıkarılabilmesi
↓
Kaynağın cevapta citation veya mention olarak kullanılabilmesi
Dolayısıyla ChatGPT görünürlüğünü yalnızca klasik “ranking” mantığıyla açıklamak yetersiz kalıyor. GEO açısından daha doğru soru artık:
“Kaçıncı sıradayım?”
değil,
“AI sistemi içeriğimi bulabiliyor, okuyabiliyor, güvenilir bir iddiaya bağlayabiliyor ve cevap üretirken kullanıyor mu?”
olabilir.

Okur yorumları 0
İlk yorumu sen yaz.
Bu yazı hakkındaki düşünceni paylaş, sohbeti başlat.